Rekan ArtonLabs, machine learning kini bukan lagi barang mewah milik segelintir perusahaan raksasa teknologi. Ia sudah merambat ke sistem rekomendasi belanja, filter spam, deteksi penipuan transaksi, sampai prediksi perawatan mesin di lantai pabrik. Sayangnya, ada jarak yang cukup lebar antara model yang terlihat canggih di sebuah notebook dan model yang benar-benar berguna di lapangan. Banyak proyek berhenti di tahap eksperimen karena dianggap "sudah selesai" begitu akurasinya bagus, padahal tantangan sesungguhnya baru dimulai ketika model harus melayani ribuan permintaan setiap hari. Artikel ini membahas bagaimana membawa machine learning dari sekadar eksperimen menjadi layanan yang andal dan bisa dipercaya.
Supaya perjalanan kita lebih terarah, berikut peta pembahasan yang akan kita telusuri bersama:
- Dari Notebook ke Produksi: Titik Kritis yang Sering Terlewat
- Kualitas Data Menentukan Segalanya
- Memilih Model: Sederhana Sering Menang
- MLOps: Menjaga Model Tetap Sehat Setelah Rilis
- Menghitung Biaya dan Menjaga Efisiensi
- Tren yang Perlu Anda Cermati
Dari Notebook ke Produksi: Titik Kritis yang Sering Terlewat
Di notebook, data biasanya sudah bersih, ukurannya kecil, dan semuanya berjalan dalam satu lingkungan yang rapi. Di produksi, ceritanya berubah total. Data datang terlambat, ada nilai kosong, format berubah tanpa pemberitahuan, dan model harus merespons dalam hitungan milidetik. Inilah mengapa memperlakukan model sebagai produk, bukan sebagai skrip, menjadi penting. Anda perlu pipeline yang bisa diulang, versi data yang terlacak, serta cara mengemas model ke dalam layanan yang mudah dipanggil sistem lain, misalnya lewat REST API.
Kualitas Data Menentukan Segalanya
Ada ungkapan lama yang tetap relevan: sampah masuk, sampah keluar. Model sehebat apa pun tidak akan menolong jika datanya keliru. Praktik yang sehat mencakup pemeriksaan konsistensi kolom, penanganan nilai hilang, serta waspada terhadap data leakage, yaitu situasi ketika informasi dari masa depan tanpa sadar ikut masuk ke pelatihan. Untuk menguji seberapa tangguh model, teknik seperti cross validation jauh lebih jujur daripada satu kali pembagian data. Tambahkan pula pemantauan terhadap distribusi data masukan, karena dunia nyata terus bergeser dan pola yang dulu akurat bisa perlahan meleset.
Memilih Model: Sederhana Sering Menang
Tidak semua masalah butuh jaringan saraf berlapis-lapis. Untuk tabel data berukuran sedang, model seperti regresi logistik atau pohon keputusan yang dikombinasikan kerap memberi hasil kompetitif dengan biaya dan waktu pelatihan yang jauh lebih murah. Barulah ketika berhadapan dengan teks, gambar, atau audio bervolume besar, deep learning dan model transformer mulai menunjukkan keunggulannya. Prinsipnya sederhana: mulailah dari solusi paling ringan, ukur dengan metrik yang sesuai tujuan bisnis, lalu naikkan kompleksitas hanya jika benar-benar diperlukan. Ingat, metrik seperti akurasi bisa menyesatkan pada data yang tidak seimbang, sehingga presisi, recall, atau F1 sering lebih informatif.
MLOps: Menjaga Model Tetap Sehat Setelah Rilis
Merilis model adalah titik awal, bukan garis akhir. Setelah berjalan, Anda perlu tahu apakah prediksinya masih masuk akal dan apakah sistemnya sehat. Beberapa kebiasaan yang membantu:
- Simpan versi model dan data agar setiap keputusan bisa ditelusuri kembali.
- Pantau performa secara berkala dan bandingkan dengan hasil nyata di lapangan.
- Siapkan jalur rollback cepat bila versi baru ternyata merugikan.
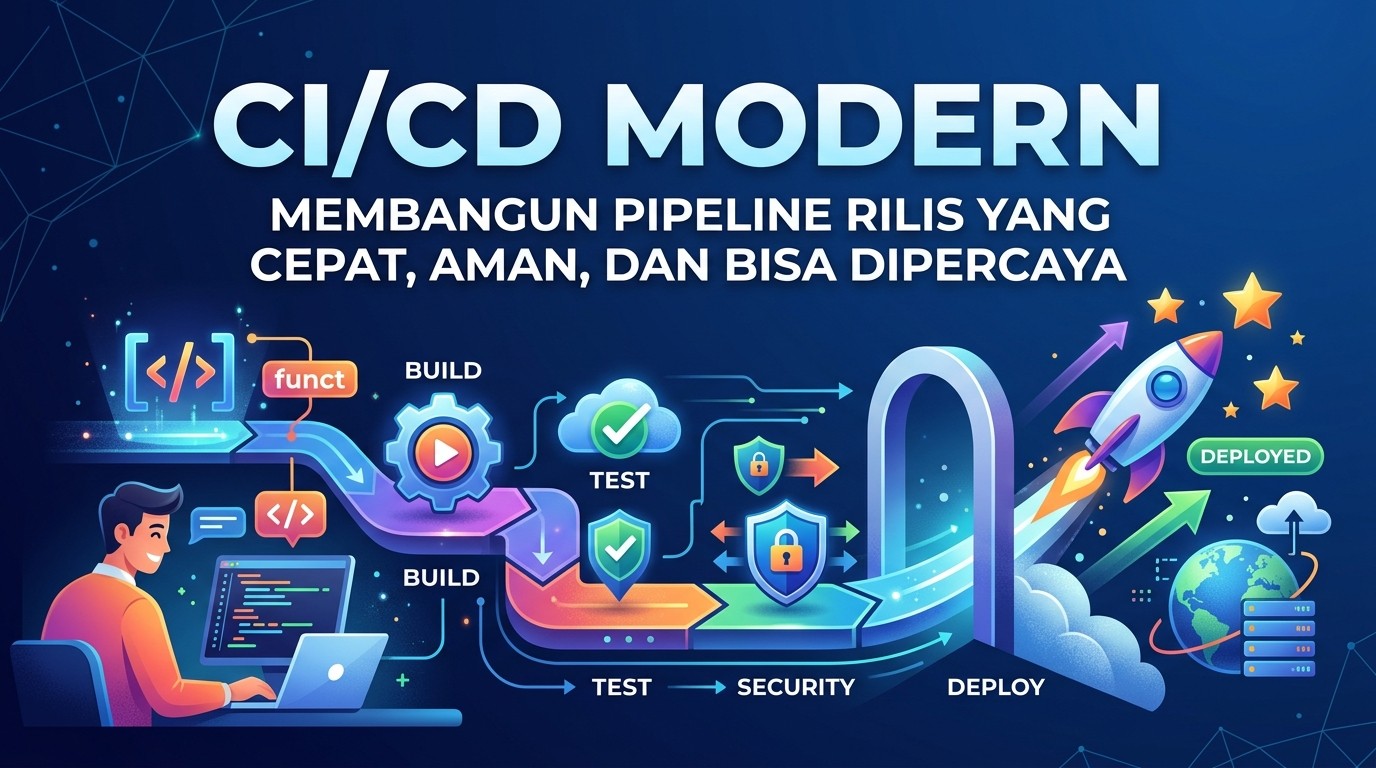
- Otomatiskan pelatihan ulang lewat pipeline yang terjadwal, bukan mengandalkan ingatan manusia.
Dengan cara ini, machine learning diperlakukan seperti perangkat lunak lain yang layak dirawat, bukan proyek sekali jadi yang kemudian ditinggalkan.
Menghitung Biaya dan Menjaga Efisiensi
Komputasi untuk melatih dan menjalankan model tidak gratis. Pelatihan berskala besar membutuhkan akselerator yang mahal, sementara inferensi yang terus berjalan menggerus anggaran setiap bulan. Beberapa strategi penghematan yang praktis antara lain memilih ukuran model yang proporsional, memanfaatkan teknik kuantisasi, serta menjalankan model ringan langsung di perangkat tepi ketika latensi rendah lebih penting daripada akurasi ekstrem. AutoML dan pencarian hiperparameter juga bisa memangkas waktu eksperimen, asalkan tetap dikendalikan agar tidak berubah menjadi pemborosan sumber daya.
Tren yang Perlu Anda Cermati
Lanskap machine learning terus bergerak. Model multimodal yang mampu memproses teks, gambar, dan suara sekaligus makin mudah diakses. Pendekatan yang menggabungkan pencarian informasi dengan model bahasa besar membantu jawaban menjadi lebih berdasar. Selain itu, kesadaran akan etika, transparansi, dan perlindungan data makin menjadi syarat, bukan pelengkap. Bagi tim yang baru memulai, langkah paling bijak bukan mengejar yang paling mutakhir, melainkan membangun fondasi data dan proses yang rapi lebih dulu.
Rekan ArtonLabs, terima kasih sudah menyimak pembahasan ini sampai tuntas. Semoga gambaran di atas membantu Anda menilai kesiapan proyek machine learning, baik yang sedang dirancang maupun yang sudah berjalan. Jika ada pertanyaan seputar topik ini, jangan ragu menghubungi kami melalui halaman kontak.