Halo, Rekan ArtonLabs. Kalau Anda pernah merasa aneh ketika mesin penerjemah menerjemahkan "panas" menjadi suhu udara padahal konteksnya sedang membicarakan sakit demam, atau saat chatbot perusahaan menjawab kaku karena tidak paham kata "gimana" dan "bangeet", maka Anda sudah menyentuh persoalan inti Natural Language Processing di Indonesia: bahasa kita kaya akan konteks, singkatan, dan lapisan makna yang tidak selalu hadir di korpus berbahasa Inggris. Separuh pekerjaan NLP sebenarnya bukan soal model, melainkan soal memahami bahasa yang sedang diolah. Artikel ini membahas bagaimana merancang sistem NLP yang benar-benar paham Bahasa Indonesia, mulai dari tahap praproses hingga pengawasan setelah model dipakai pengguna sungguhan.
Supaya perjalanan membaca Anda lebih terarah, berikut ringkasan bahasan yang akan kita telusuri bersama:
- Karakter Bahasa Indonesia yang Sering Terlupakan Model
- Alur Kerja NLP: dari Teks Mentah Menuju Makna
- Embedding dan Model Pra-latih yang Tersedia
- Jebakan Praktis di Lapangan
- Cara Mengukur Kualitas Secara Jujur
- Menjaga Model Tetap Relevan Setelah Rilis
Karakter Bahasa Indonesia yang Sering Terlupakan Model
Bahasa Indonesia adalah bahasa yang relatif jarang (low-resource) bila dibandingkan Inggris, Mandarin, atau Spanyol dalam hal data latih berkualitas. Akibatnya, model yang dilatih dominan pada teks Inggris sering "menebak" struktur Indonesia dengan asumsi yang salah. Beberapa ciri yang perlu Anda perhatikan:
- Imbuhan berlapis. Kata "mempertanggungjawabkannya" membawa informasi pelaku, objek, dan aspek sekaligus. Pemotongan kata (stemming) yang terlalu agresif justru menghapus sinyal penting.
- Singkatan informal. "yg", "tdk", "bgt", "gmn" adalah bentuk normal di media sosial. Normalisasi teks informal bukan kemewahan, melainkan kebutuhan dasar.
- Campur kode. Satu kalimat bisa berisi istilah teknis Inggris dan partikel lokal. Model perlu dilatih pada data code-mixing agar tidak bingung.
- Ambiguitas tanpa tanda baca. Teks dari chat sering tanpa kapital dan titik, sehingga batas kalimat harus ditebak sendiri.
Alur Kerja NLP: dari Teks Mentah Menuju Makna
Secara garis besar, pipeline NLP modern tetap mengikuti urutan yang sama meski modelnya makin besar. Pertama, pembersihan teks: hapus HTML, normalkan karakter unicode, tangani emoji dan mention. Kedua, tokenisasi yang sadar bahasa — bukan sekadar memotong spasi, tetapi mengenali imbuhan dan kata ulang seperti "anak-anak". Ketiga, representasi numerik atau embedding. Keempat, model tugas akhir: klasifikasi sentimen, ekstraksi entitas, ringkasan, pencarian semantik, atau pembangkitan jawaban.
Yang sering terlewat justru tahap nol: memahami tujuan bisnis. Apakah Anda butuh klasifikasi keluhan pelanggan per kategori, atau butuh pencarian dokumen dengan makna mirip? Dua kebutuhan ini memerlukan pendekatan, metrik, dan data latih yang sangat berbeda. Menetapkan hal ini di awal akan menghemat berminggu-minggu kerja yang salah arah.
Embedding dan Model Pra-latih yang Tersedia
Kabar baiknya, ekosistem model berbahasa Indonesia sudah cukup matang. Untuk tugas pemahaman teks seperti klasifikasi dan pencarian, model berbasis arsitektur Transformer yang dilatih khusus pada korpus Indonesia memberi hasil jauh lebih baik daripada model multibahasa serba bisa. Untuk kebutuhan yang ringan, Anda bisa mulai dari pendekatan klasik seperti TF-IDF ditambah pengklasifikasi linear — sering kali cukup akurat, cepat, murah, dan jauh lebih mudah dijelaskan kepada pemangku kepentingan.
Untuk pencarian semantik dan tanya-jawab berbasis dokumen, kombinasi embedding kalimat plus basis data vektor (misalnya ChromaDB) memungkinkan sistem menemukan paragraf relevan tanpa bergantung pada kecocokan kata kunci persis. Sementara itu, untuk pembangkitan teks, Anda bisa memilih model bahasa besar lewat API atau menjalankan model terbuka secara lokal dengan llama.cpp bila isu privasi data menjadi prioritas.
Jebakan Praktis di Lapangan
Beberapa kesalahan berulang yang saya amati saat tim mulai mengerjakan NLP:
- Data latih tidak mewakili pengguna. Model dilatih dari ulasan berbahasa formal, lalu diuji pada chat pelanggan yang penuh singkatan. Akurasi anjlok di produksi.
- Kebocoran data (data leakage). Data uji tercampur ke data latih sehingga metrik terlihat sempurna namun performa nyata mengecewakan.
- Label yang tidak konsisten. Tiga pemberi label punya tiga definisi berbeda soal "keluhan" versus "pertanyaan". Model belajar kebingungan tim, bukan pola bahasa.
- Terlalu cepat memakai model terbesar. Biaya inferensi dan latensi naik, sementara peningkatan akurasi hanya satu hingga dua persen.
Cara Mengukur Kualitas Secara Jujur
Jangan berhenti pada akurasi. Untuk klasifikasi dengan kelas tidak seimbang, gunakan precision, recall, dan F1 per kelas agar Anda tahu di mana model benar-benar gagal. Untuk ekstraksi entitas, evaluasi per jenis entitas. Untuk ringkasan atau pembangkitan, metrik otomatis seperti BLEU dan ROUGE hanya indikator awal — penilaian manusia tetap diperlukan karena teks yang skornya tinggi bisa terasa kaku dan tidak wajar. Buat juga set evaluasi tetap yang tidak pernah dipakai untuk pelatihan, sehingga Anda punya pembanding stabil dari waktu ke waktu.
Menjaga Model Tetap Relevan Setelah Rilis
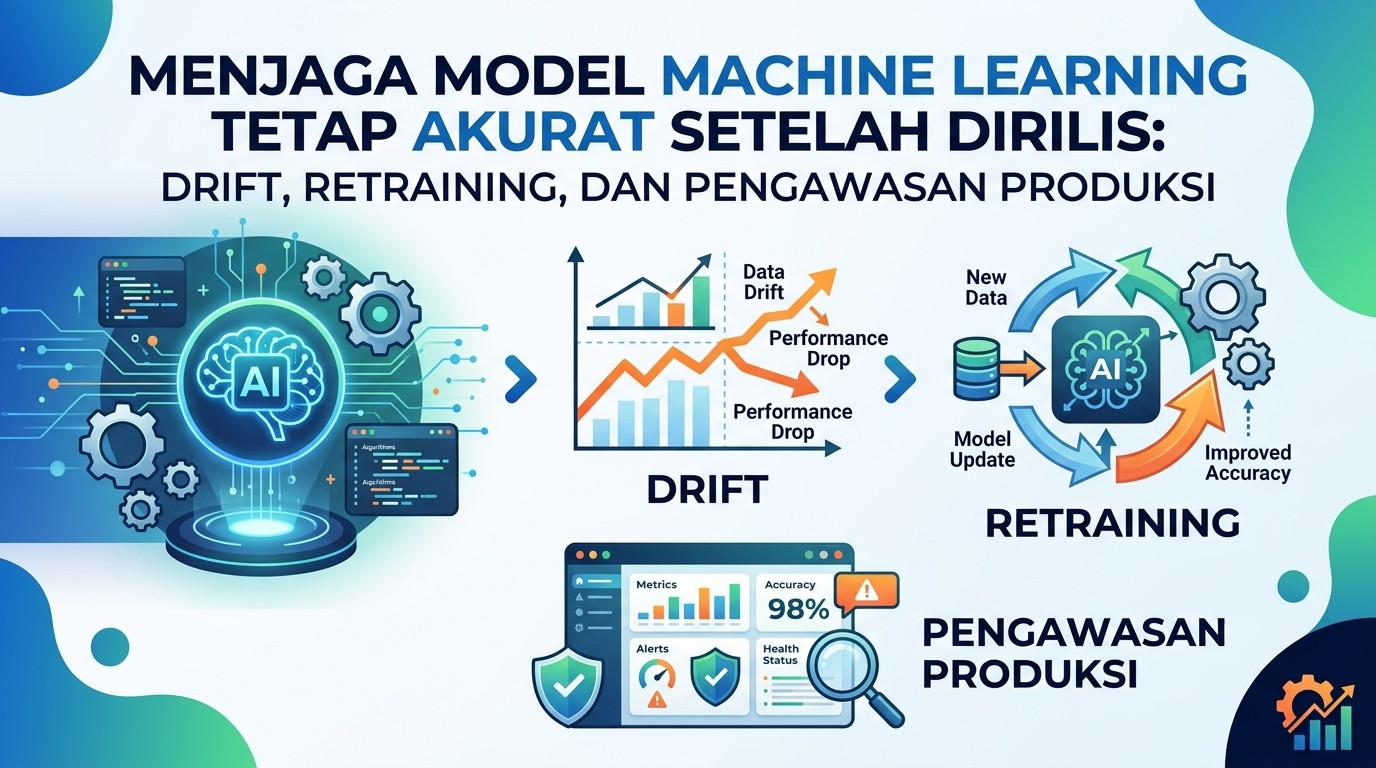
Bahasa bergeser lebih cepat daripada siklus rilis perangkat lunak. Istilah baru, singkatan musiman, dan perubahan gaya bicara membuat model yang dulu akurat perlahan melenceng. Karena itu, sediakan mekanisme pengawasan: catat distribusi label prediksi, pantau tingkat keyakinan model, dan simpan sampel masukan berkeyakinan rendah untuk ditinjau manusia. Ketika pola menyimpang terdeteksi, lakukan pelabelan tambahan dan latih ulang secara berkala — bukan menunggu keluhan pengguna menumpuk. Perlakukan NLP sebagai layanan hidup, bukan proyek sekali jadi.
Rekan ArtonLabs, membangun NLP berbahasa Indonesia yang andal memang menuntut kesabaran pada tahap data dan evaluasi, tetapi justru di situlah keunggulan kompetitifnya berada. Terima kasih sudah membaca sampai akhir; jika ada bagian yang ingin Anda diskusikan lebih dalam — mulai dari pemilihan model, normalisasi teks informal, sampai strategi pengawasan di produksi — silakan sampaikan pertanyaan Anda lewat halaman kontak kami. Kami senang membantu.