Halo, Rekan ArtonLabs. Kalau selama ini Anda menganggap kamera hanya alat untuk merekam momen, ada baiknya kita melihatnya dari sudut pandang yang berbeda. Kamera hari ini bisa menghitung jumlah kendaraan di jalan raya, memeriksa kualitas produk di lini produksi, membaca plat nomor secara otomatis, bahkan membantu dokter menandai area mencurigakan pada hasil pencitraan medis. Semua itu berkat Computer Vision atau penglihatan komputer—bidang kecerdasan buatan yang melatih mesin agar mampu "melihat", mengenali, dan mengambil keputusan dari gambar maupun video. Artikel ini akan mengajak Anda memahami cara kerjanya, teknologi yang sedang dipakai, sampai langkah praktis untuk mulai membangun proyek sendiri.
Supaya perjalanan membaca Anda lebih terarah, berikut peta pembahasannya:
- Dari piksel ke pemahaman: apa sebenarnya computer vision
- Empat tugas inti yang jadi fondasi sebagian besar aplikasi
- Perjalanan arsitektur: dari CNN sampai Vision Transformer
- Perkakas dan model terbuka yang mempercepat pekerjaan
- Contoh penerapan nyata di lapangan
- Menjalankan model di tepi jaringan
- Tantangan yang masih sering menggigit
- Langkah praktis untuk memulai proyek pertama
Dari Piksel ke Pemahaman
Bagi komputer, sebuah foto hanyalah matriks angka. Gambar berukuran 1920×1080 piksel menyimpan lebih dari dua juta titik, masing-masing berisi nilai intensitas warna. Tugas computer vision adalah mengubah tumpukan angka itu menjadi informasi bermakna: "ada tiga orang", "kotak ini cacat", atau "area ini bukan jaringan sehat".
Yang menarik, mesin tidak diberi tahu aturan bentuk mata atau roda secara manual. Model deep learning mempelajari sendiri pola-pola penting—tepi, sudut, tekstur, lalu kombinasi yang makin kompleks—langsung dari ribuan contoh berlabel. Inilah alasan kualitas dan variasi data latih begitu menentukan hasil akhir.
Empat Tugas Inti yang Jadi Fondasi
Hampir semua produk berbasis penglihatan komputer dibangun dari satu atau beberapa tugas berikut:
- Klasifikasi gambar — memberi satu label pada seluruh gambar, misalnya "daun sehat" atau "daun terserang hama".
- Deteksi objek — menemukan lokasi objek dengan kotak pembatas sekaligus labelnya. Keluarga model YOLO adalah yang paling populer karena cepat dan mudah dipakai.
- Segmentasi — memberi label pada tingkat piksel. Varian instance segmentation memisahkan setiap objek, sedangkan semantic segmentation mengelompokkan area berdasarkan kelas.
- Estimasi pose dan pelacakan — memetakan titik-titik tubuh atau melacak objek antar-frame video untuk menganalisis gerakan.
Menentukan tugas yang tepat sejak awal akan menghemat banyak waktu. Kesalahan paling umum adalah memaksakan klasifikasi untuk masalah yang sebenarnya butuh deteksi.
Perjalanan Arsitektur: dari CNN sampai Vision Transformer
Selama bertahun-tahun, Convolutional Neural Network (CNN) menjadi tulang punggung bidang ini. Lapisan konvolusi bekerja seperti filter geser yang menangkap pola lokal, lalu menggabungkannya menjadi representasi tingkat tinggi. Efisiensinya membuat CNN sangat cocok untuk perangkat dengan daya terbatas.
Belakangan, pengaruh Transformer merambah ke ranah visual. Vision Transformer memotong gambar menjadi kepingan kecil (patch) dan memprosesnya seperti urutan kata, sehingga mampu menangkap hubungan antar bagian gambar secara global. Model fondasi visual yang dilatih tanpa label dalam skala besar kini menjadi titik awal yang kuat untuk banyak tugas hilir. Untuk praktik sehari-hari, pendekatan hibrida sering paling masuk akal: backbone modern yang efisien dipadukan dengan kepala deteksi atau segmentasi ringan.
Perkakas dan Model Terbuka yang Mempercepat Pekerjaan
Kabar baiknya, Anda tidak perlu membangun semuanya dari nol. Ekosistem sumber terbuka menyediakan bahan yang sudah matang:
- OpenCV — fondasi pengolahan gambar: pembacaan video, transformasi geometri, filtering, hingga kalibrasi kamera.
- Ultralytics (YOLO) — alur latih yang rapi untuk deteksi, segmentasi, dan pose, lengkap dengan ekspor ke ONNX atau TensorRT.
- Model segmentasi serbaguna — memungkinkan pemisahan objek hanya dengan titik atau kotak sebagai petunjuk, tanpa latih ulang.
- PyTorch dan ONNX Runtime — standar de facto untuk riset sekaligus jalur optimasi saat masuk produksi.
- Anotasi data — alat berlabel berbasis web memudahkan tim kecil membangun dataset sendiri secara konsisten.
Contoh Penerapan Nyata di Lapangan
Di sektor manufaktur, inspeksi visual otomatis memeriksa cacat permukaan jauh lebih konsisten daripada mata manusia yang cepat lelah. Sektor pertanian memakai kamera drone untuk mendeteksi stres tanaman dan memperkirakan hasil panen. Ritel memanfaatkan analisis rak untuk memantau ketersediaan stok, sementara logistik mengandalkan pembacaan otomatis pada gerbang masuk untuk mengenali truk dan kontainer.
Di ranah publik, penglihatan komputer membantu pemantauan kepadatan lalu lintas dan deteksi pelanggaran. Namun penerapan yang menyentuh ruang publik wajib dibarengi pertimbangan privasi: hindari identifikasi biometrik yang tidak perlu, terapkan penyamaran wajah, dan tegaskan dasar hukum serta masa simpan data.
Menjalankan Model di Tepi Jaringan
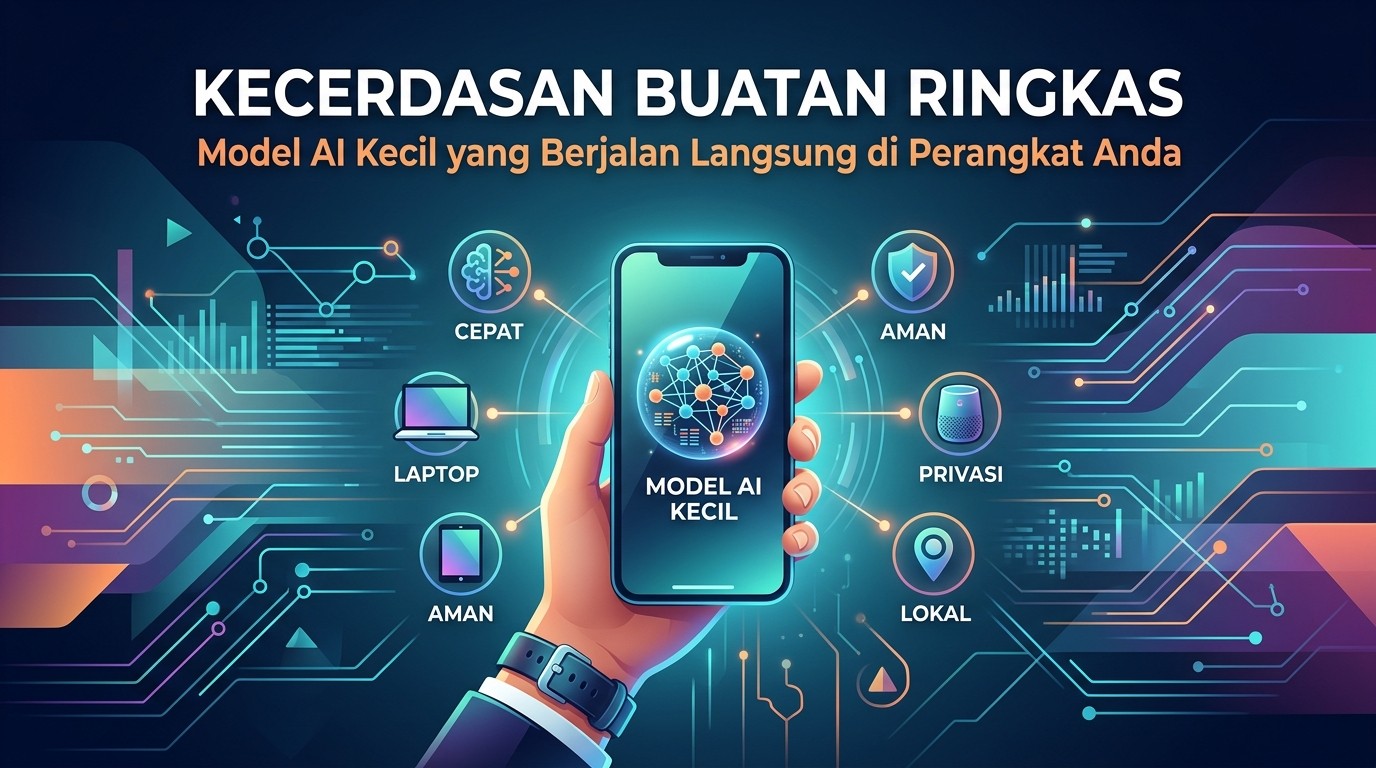
Mengirim seluruh video mentah ke cloud itu mahal dan lambat. Karena itu tren besar saat ini adalah edge inference: model dikompresi lalu dijalankan langsung di kamera pintar, mini PC, atau perangkat pendamping. Teknik kuantisasi, pemangkasan, dan ekspor ke format yang dioptimalkan untuk perangkat keras tertentu bisa memangkas ukuran model secara drastis tanpa kehilangan akurasi berarti. Hasilnya, keputusan bisa diambil dalam hitungan milidetik, bandwidth jauh lebih hemat, dan data sensitif tidak perlu keluar dari lokasi.
Tantangan yang Masih Sering Menggigit
Jangan tertipu demo yang selalu tampak mulus. Beberapa jebakan yang kerap muncul:
- Domain shift — model yang jago di ruangan terang bisa kacau saat dipasang di gudang minim cahaya.
- Data tidak seimbang — kasus cacat produk biasanya langka, sehingga akurasi keseluruhan terlihat bagus padahal model gagal mengenali kasus penting.
- Bias dan etika — dataset yang tidak beragam bisa menurunkan performa pada kelompok tertentu.
- Pemantauan pasca-rilis — kualitas kamera berubah, posisi berubah, performa menurun. Perlu monitoring berkelanjutan, bukan evaluasi sekali jalan.
Langkah Praktis untuk Memulai Proyek Pertama
Mulailah dari masalah yang sempit dan terukur. Kumpulkan beberapa ratus gambar yang benar-benar mewakili kondisi lapangan, beri label secara konsisten, lalu latih model kecil sebagai pembanding awal. Ukur dengan metrik yang sesuai—untuk deteksi, gunakan mean average precision sekaligus tingkat kesalahan pada kelas minoritas. Setelah hasilnya stabil, barulah berpikir soal optimasi kecepatan dan penyebaran ke perangkat.
Terakhir, bangun mekanisme umpan balik: kumpulkan contoh kasus yang salah ditebak di produksi, lalu jadikan bahan perbaikan model berikutnya. Siklus itulah yang membedakan proyek eksperimen dari sistem yang benar-benar tahan lama.
Terima kasih sudah menyempatkan waktu membaca sampai selesai, Rekan ArtonLabs. Kalau ada bagian yang ingin Anda dalami—misalnya memilih arsitektur model, menyiapkan dataset, atau merancang alur inferensi di perangkat tepi—jangan ragu untuk bertanya lewat halaman kontak kami. Kami dengan senang hati mendiskusikannya bersama Anda.